Sprache‑zu‑Sprache‑Übersetzung in Echtzeit für Live‑Audio
Ein Mikrofon rein.
Vier Sprachen raus.
Ein Eingang vom Audio‑Interface. Bis zu vier Ausgangskanäle, jeder in seiner eigenen Sprache, gesprochen in Echtzeit. Für Versammlungen, Live‑Events und Livestreams, damit niemand zurückbleibt.
- Isoliert oder geduckt
- Keine Rückübersetzung
- Routing pro Kanal
- Optional bis zu 16 Sprachen
Entwickelt in Österreich, Europa
DSGVO‑konform
Das Problem
Jede weitere Sprache bedeutet noch eine Kabine, noch einen Feed, mehr Abstimmung.
Mehrsprachiges Publikum ist bei Events und Livestreams normal. Eine Sprache hinzuzufügen ist es nicht.
Fürs Handy gebaut, nicht fürs Pult
Die meisten KI‑Übersetzer sind für eine Person mit Smartphone gemacht: Untertitel auf einem Bildschirm oder eine Stimme im Ohrhörer.
Ein Tonpult braucht Feeds
Ein Mischpult, ein Stream‑Encoder oder eine Dolmetschanlage braucht pro Sprache einen sauberen, getrennten Audio‑Feed.
Jede Sprache macht Arbeit
Jede weitere Sprache heißt meist: noch eine Kabine, noch ein Kanal zum Patchen, noch mehr Leute zu koordinieren.
Für wen
Damit niemand zurückbleibt
Nützlich überall, wo Menschen mit unterschiedlichen Sprachen zusammenkommen: von der Generalversammlung bis zum Live‑Event. Alle hören den Vortrag in ihrer eigenen Sprache.
Versammlungen
Haupt- und Generalversammlungen, Mitgliederversammlungen und Sitzungen, bei denen alle jedes Wort verstehen sollen.
Live‑Events
Konferenzen, Podien und Keynotes mit internationalem Publikum im Saal.
Livestreams
Ein eigener Sprach‑Feed pro Stream, direkt in den Encoder.
Interne Events
Town Halls und All‑Hands‑Meetings für Teams in mehreren Ländern.
So funktioniert’s
Ein Eingang. Bis zu vier Sprachkanäle.
Der Vortrag wird in Echtzeit transkribiert, übersetzt und neu gesprochen. Jede Sprache landet auf ihrem eigenen physischen Ausgang.
Eingang wählen
Audio‑Interface und den Eingangskanal mit dem Vortrag auswählen.
Jedem Kanal eine Sprache geben
Englisch auf Out 1, Deutsch auf Out 2 und so weiter. Kanal 3 und 4 starten ausgeschaltet, damit nichts versehentlich läuft oder kostet.
Routen und live gehen
Jede Sprache auf einen beliebigen physischen Ausgang legen und Start drücken. Ein Live‑Transkript zeigt das Original und jeden Kanal.
Funktionen
Alles, was ein Sprachkanal braucht
Sprache rein, Sprache raus
Sprache‑zu‑Sprache in Echtzeit, mit weiblicher, männlicher oder an den Sprecher angepasster Stimme pro Kanal.
4 Kanäle, bis zu 16 Sprachen
Ein Eingang speist bis zu vier Ausgangskanäle, jeden in seiner eigenen Sprache. Optional bis zu 16 Übersetzungssprachen.
Automatisch oder fest
Die automatische Erkennung folgt Vortragenden, die die Sprache wechseln. „Fest“ ist für den Fall, dass Sie wissen, wer auf der Bühne steht.
Live‑Transkript
Ein laufendes Transkript des Originals und jedes Kanals, zum Abhören und Mitlesen.
Jeder Ausgang, jeder Kanal
Jede Sprache kann auf jeden physischen Ausgang Ihres Interfaces.
Eigenständige Mac‑App
Bringt ihre eigene Laufzeitumgebung mit. Doppelklick, und sie öffnet sich im eigenen Fenster: keine Installation, kein Terminal.
Am Live‑Pult
Die Details, auf die es am Live‑Pult ankommt
Keine Rückübersetzung derselben Sprache
Spricht der Vortrag schon die Sprache eines Kanals, bekommt dieser Kanal die Originalstimme statt einer maschinellen Nachsprache. Bei fester Eingangssprache öffnet dieser Kanal gar keine Übersetzungssitzung.
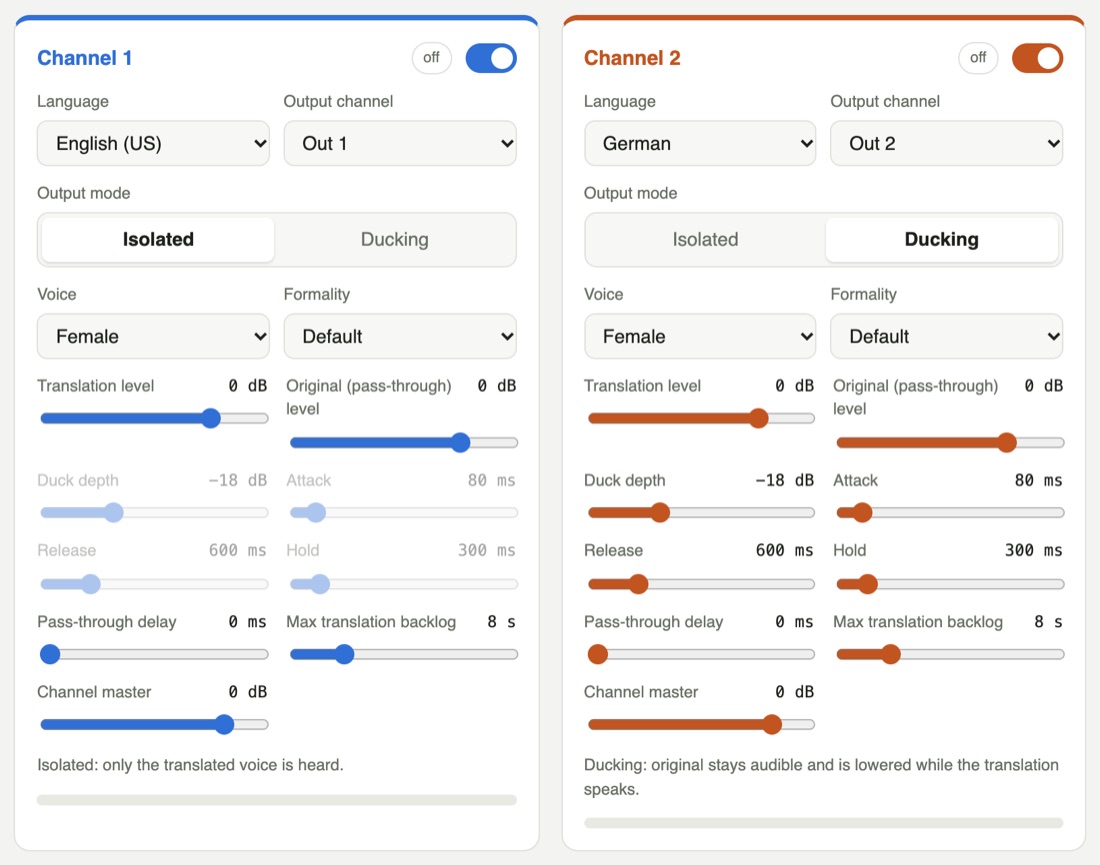
Isoliert oder geduckt, pro Kanal
Isoliert sendet nur die übersetzte Stimme, wie ein Dolmetsch‑Feed. Ducking lässt das Original darunter laufen und senkt es, während die Übersetzung spricht, wie ein Voice‑over im Fernsehen.
Timing, das ein minimiertes Fenster übersteht
Die Ducking‑Hüllkurve läuft auf der Audio‑Uhr statt auf einem UI‑Timer. Sie bleibt genau, auch wenn das Fenster im Hintergrund liegt, wie es auf einem Produktionsrechner meist der Fall ist.
Echtes Routing
Jede Sprache kann auf jeden physischen Ausgang des Interfaces: direkt ins Mischpult, in einen Stream‑Encoder oder in eine Dolmetschanlage.
Pro Kanal einstellbar
- Sprache und Stimme
- Ausgangskanal
- Isoliert oder Ducking
- Duck‑Tiefe, Attack, Hold, Release
- Pegel von Übersetzung und Original
- Verzögerung für das Original
- Maximaler Übersetzungsrückstand
- Kanal‑Master
Eigenständig
Weil Produktionsrechner keine Entwicklerrechner sind
Läuft auf Ihrem Mac
Eine App für Intel und Apple Silicon, ab macOS 13.5. Sie bringt ihre eigene Laufzeitumgebung mit. Eine Windows‑Version ist in Entwicklung.
Der Schlüssel bleibt am Gerät
Der API‑Schlüssel wird einmal eingegeben und lokal gespeichert, lesbar nur für dieses Benutzerkonto.
Nur lokal
Die App nimmt nur Verbindungen vom eigenen Rechner an und lehnt Anfragen anderer Websites ab.
Braucht einen Chromium‑Browser
Chrome, Edge oder Brave muss installiert sein: Sie können Audio an einen gewählten Ausgangskanal senden.
Über das Pult hinaus
Speech Connect für Ihr Publikum
Speech Connect erreicht das Publikum auch direkt: Spracherkennung und Übersetzung in mehrere Sprachen gleichzeitig, zu den Zuhörenden gebracht, zusammen mit Werkzeugen, die sie einbinden.
Erkennung in Echtzeit
Die Spracherkennung macht aus der Stimme Text, während gesprochen wird.
Mehrere Sprachen
Einen Vortrag gleichzeitig in mehrere Sprachen übersetzen, mit natürlich klingenden Stimmen.
Live‑Streaming
Die Übersetzungen live an Ihr Publikum streamen, bei Events und Präsentationen.
Audio‑Streaming
Das übersetzte Audio direkt zu Ihren Zuhörenden bringen.
Live‑Untertitel
Mehrsprachige Untertitel für Live‑Events, Webinare und Videos.
Interaktiver Chat
Das Publikum chattet und gibt Feedback, über Sprachgrenzen hinweg.
Live‑Abstimmungen
Mehrsprachige Umfragen und Abstimmungen für Q&A, Befragungen und interaktive Präsentationen.
Interaktive Spiele
Mehrsprachige Wortspiele und Quizze, die das Publikum bei der Sache halten.
Ehrliche Grenzen
Was es (noch) nicht kann
Kennen Sie die Kompromisse, bevor Sie auf Sendung gehen.
Es hängt ein paar Sekunden hinterher
Übersetzt wird Satz für Satz. Für einen Sprachkanal im Livestream oder eine interne Town Hall passt das, Simultandolmetscher in heiklen Situationen ersetzt es nicht.
Jede Sprache kostet
Jeder übersetzte Kanal ist eine eigene Echtzeit‑Sitzung und wird als solche abgerechnet: vier Sprachen verbrauchen viermal so viele Minuten.
Die Erkennung braucht die ersten Worte
Bis dahin kennt die App die Sprache nicht. Eine kurze Verzögerung des Originals überbrückt das, eine feste Eingangssprache vermeidet es.
Es braucht einen Chromium‑Browser
Chrome, Edge oder Brave, weil sie Audio an einen gewählten Ausgangskanal leiten können.
FAQ
Häufige Fragen
Was macht Speech Connect genau?
Es nimmt einen Vortrag von einem Eingang Ihres Audio‑Interfaces, übersetzt ihn in Echtzeit und spricht ihn in bis zu vier Sprachen neu. Jede Sprache kommt auf einem eigenen Ausgangskanal heraus und kann direkt ins Mischpult, in einen Stream‑Encoder oder in eine Dolmetschanlage.
Für wen ist es gedacht?
Für alle, die den Ton für mehrsprachiges Publikum machen: Haupt- und Generalversammlungen, Konferenzen und Live‑Events, Livestreams, interne Town Halls und hybride Meetings. Das Ziel ist einfach: Niemand im Publikum bleibt zurück.
Wie viele Sprachen laufen gleichzeitig?
Bis zu vier Ausgangskanäle, jeder in seiner eigenen Sprache, aus einem Eingang. Kanal 1 und 2 sind standardmäßig an; Kanal 3 und 4 starten ausgeschaltet, damit nichts versehentlich läuft oder kostet. Optional verarbeitet Speech Connect bis zu 16 Übersetzungssprachen.
Ersetzt es Simultandolmetscher?
Nein. Die Übersetzung hängt dem Vortrag ein paar Sekunden hinterher, Satz für Satz. Für Verhandlungen und andere heikle Situationen buchen Sie Dolmetscher. Es passt dort, wo ein sauberer, automatischer Sprachkanal reicht, zum Beispiel im Livestream, bei einer Generalversammlung oder bei einem internen Event.
Wie weit liegt die Übersetzung zurück?
Meist ein paar Sekunden, weil Satz für Satz übersetzt wird. Ein Grenzwert pro Kanal, der maximale Übersetzungsrückstand, verwirft wartende Sprache, wenn ein Kanal zu weit zurückfällt. So holt er auf, statt abzudriften.
Wie klingt die übersetzte Stimme?
Jeder Kanal spricht mit einer weiblichen, männlichen oder an den Sprecher angepassten Stimme. Sie wählen pro Kanal.
Hört das Publikum noch das Original?
Ja, wenn Sie wollen. Im Ducking‑Modus bleibt das Original darunter und wird abgesenkt, während die Übersetzung spricht, wie ein Voice‑over im Fernsehen. Im isolierten Modus ist nur die Übersetzung zu hören, wie ein Dolmetsch‑Feed. Sie wählen pro Kanal.
Und wenn schon in der Sprache eines Kanals gesprochen wird?
Dann bekommt dieser Kanal die Originalstimme statt einer maschinellen Nachsprache. Bei fester Eingangssprache öffnet dieser Kanal gar keine Übersetzungssitzung.
Und wenn die Sprache wechselt?
Mit automatischer Erkennung wird die Sprache laufend erkannt. Ein Kanal in der gerade gesprochenen Sprache bekommt die Originalstimme. Die Erkennung braucht die ersten Worte; eine Verzögerung des Originals überbrückt das, oder Sie stellen die Eingangssprache fest ein.
Welche Sprachen werden unterstützt?
Die Ausgabesprachen sind jene, die die Echtzeit‑Übersetzungs‑API für Sprachausgabe anbietet. Nennen Sie Ihre Sprachen im Formular, wir bestätigen sie vor der Demo.
Funktioniert es mit meinem Mischpult, Encoder oder meiner Dolmetschanlage?
Jede Sprache kann auf jeden physischen Ausgang Ihres Audio‑Interfaces. Von dort ist es ein ganz normaler Audio‑Feed für Mischpult, Stream‑Encoder oder Dolmetschanlage.
Was lässt sich pro Kanal einstellen?
Sprache, Stimme, Ausgangskanal, Isoliert oder Ducking, Duck‑Tiefe, Attack, Hold und Release, die Pegel von Übersetzung und Original, eine Verzögerung für das Original, der maximale Übersetzungsrückstand und ein Kanal‑Master.
Kann ich mithören, was gesagt wird?
Ja. Ein Live‑Transkript zeigt laufend das Original und jeden Kanal.
Läuft es weiter, wenn das Fenster im Hintergrund ist?
Ja. Das Ducking läuft auf der Audio‑Uhr statt auf einem UI‑Timer und bleibt genau, auch wenn das Fenster minimiert oder verdeckt ist.
Was brauche ich dafür?
Einen Mac ab macOS 13.5 (Intel oder Apple Silicon), installiertes Chrome, Edge oder Brave, ein Audio‑Interface, eine Internetverbindung und ein Speech‑Connect‑Abonnement. Die App bringt ihre eigene Laufzeitumgebung mit, sonst muss nichts installiert werden.
Läuft es unter Windows?
Eine Windows‑Version ist in Entwicklung. Derzeit läuft Speech Connect für das Live‑Pult auf dem Mac; sagen Sie uns im Formular, wenn Sie auf Windows warten.
Kann ich Eingänge über 1 und 2 nutzen?
Manche Mehrkanal‑Interfaces geben dem Browser nur die ersten zwei Eingänge frei. Legen Sie den Vortrag im Mixer des Interfaces auf Eingang 1 oder 2, oder nutzen Sie ein macOS‑Aggregatgerät.
Wohin gehen mein Audio und mein API‑Schlüssel?
Das Audio wird zur Transkription, Übersetzung und Sprachausgabe an die Echtzeit‑Übersetzungs‑API gesendet. Der API‑Schlüssel wird lokal am Mac gespeichert, lesbar nur für Ihr Benutzerkonto, und die App nimmt nur Verbindungen vom eigenen Rechner an.
Ist es DSGVO‑konform?
Ja. Speech Connect wird in Österreich, in der Europäischen Union, entwickelt und ist DSGVO‑konform. Die App speichert ihren Schlüssel lokal und nimmt nur Verbindungen vom eigenen Rechner an; diese Website setzt keine Cookies und kein Tracking ein.
Wie wird abgerechnet?
Speech Connect ist ein Abo‑Dienst (SaaS). Jeder übersetzte Kanal läuft als eigene Echtzeit‑Sitzung und wird als eigene Sitzung abgerechnet: Vier Sprachen verbrauchen viermal so viele Minuten. Ein Kanal, dessen Sprache einer festen Eingangssprache entspricht, öffnet gar keine Sitzung.
Was kostet es?
Speech Connect gibt es im Abonnement. Der Preis hängt von Ihrem Setup und der Zahl der Sprachen ab. Wählen Sie im Formular „Vertrieb kontaktieren“, und wir schicken Ihnen ein Angebot.
Kann das Publikum selbst mithören?
Die Speech‑Connect‑Publikumsplattform ergänzt Audio‑Streaming an die Zuhörenden, Live‑Untertitel, Chat, Abstimmungen und Spiele. Fragen Sie uns im Formular danach.
Kontakt
Erleben Sie es mit Ihren Sprachen
Buchen Sie eine Demo oder fragen Sie den Vertrieb nach Ihrer Veranstaltung. Erzählen Sie uns kurz von Ihrem Setup, wir melden uns per E‑Mail.
Kein Newsletter, kein Tracking. Wir verwenden Ihre Angaben nur, um Ihnen zu antworten.
Danke, Ihre Anfrage ist unterwegs.
Wir antworten per E‑Mail, meist innerhalb von zwei Werktagen.