Traduction parole‑à‑parole en temps réel pour l’audio live
Un micro en entrée.
Quatre langues en sortie.
Une entrée de votre interface audio. Jusqu’à quatre canaux de sortie, chacun dans sa langue, parlés en temps réel. Pour les assemblées, les événements live et les livestreams, pour que personne ne reste de côté.
- Isolé ou en ducking
- Pas de re‑traduction
- Routage par canal
- En option : jusqu’à 16 langues
Développé en Autriche, en Europe
Conforme au RGPD
Le problème
Chaque langue en plus, c’est encore une cabine, encore un flux, plus de coordination.
Les publics multilingues sont la norme lors des événements et des livestreams. Ajouter une langue, non.
Conçus pour le téléphone, pas pour la régie
La plupart des outils de traduction par IA visent une personne avec un smartphone : des sous‑titres à l’écran ou une voix dans l’oreillette.
Une régie a besoin de flux
Une console, un encodeur de stream ou un système d’interprétation a besoin d’un flux audio propre et séparé par langue.
Chaque langue ajoute du travail
Une langue en plus signifie souvent une cabine de plus, un canal de plus à patcher et davantage de personnes à coordonner.
Pour qui
Pour que personne ne reste de côté
Utile partout où se réunissent des personnes qui parlent des langues différentes : de l’assemblée générale à l’événement live. Chacun entend l’orateur dans sa propre langue.
Assemblées générales
Assemblées générales et annuelles, réunions de membres et conseils où chacun doit suivre chaque mot.
Événements live
Conférences, tables rondes et keynotes devant un public international.
Livestreams
Un flux par langue pour chaque stream, directement dans l’encodeur.
Événements internes
Town halls et réunions plénières pour des équipes réparties dans plusieurs pays.
Fonctionnement
Une entrée. Jusqu’à quatre canaux de langue.
L’orateur est transcrit, traduit et revoisé en temps réel. Chaque langue arrive sur sa propre sortie physique.
Choisir l’entrée
Sélectionnez l’interface audio et le canal d’entrée qui porte l’orateur.
Attribuer une langue à chaque canal
Anglais sur Out 1, allemand sur Out 2, et ainsi de suite. Les canaux 3 et 4 démarrent désactivés : rien ne tourne ni ne coûte par erreur.
Router et passer à l’antenne
Envoyez chaque langue vers n’importe quelle sortie physique et appuyez sur Start. Une transcription en direct affiche l’original et chaque canal.
Fonctions
Tout ce dont un canal de langue a besoin
Parole en entrée, parole en sortie
Parole‑à‑parole en temps réel, avec une voix féminine, masculine ou proche de celle de l’orateur, par canal.
4 canaux, jusqu’à 16 langues
Une entrée alimente jusqu’à quatre canaux de sortie, chacun dans sa langue. En option, jusqu’à 16 langues de traduction.
Détection auto ou langue fixe
La détection automatique suit un orateur qui change de langue. Le mode fixe sert quand vous savez qui est sur scène.
Transcription en direct
Une transcription continue de l’original et de chaque canal, pour le contrôle.
Toute sortie, tout canal
Chaque langue peut aller vers n’importe quelle sortie physique de votre interface.
App Mac autonome
Elle embarque son propre environnement d’exécution. Double‑clic, et elle s’ouvre dans sa fenêtre : aucune installation, aucun terminal.
En régie
Les détails qui comptent en régie
Pas de re‑traduction de la même langue
Si l’orateur parle déjà la langue d’un canal, ce canal reçoit la voix originale, pas une relecture par une machine. Avec une langue d’entrée fixe, ce canal n’ouvre même pas de session de traduction.
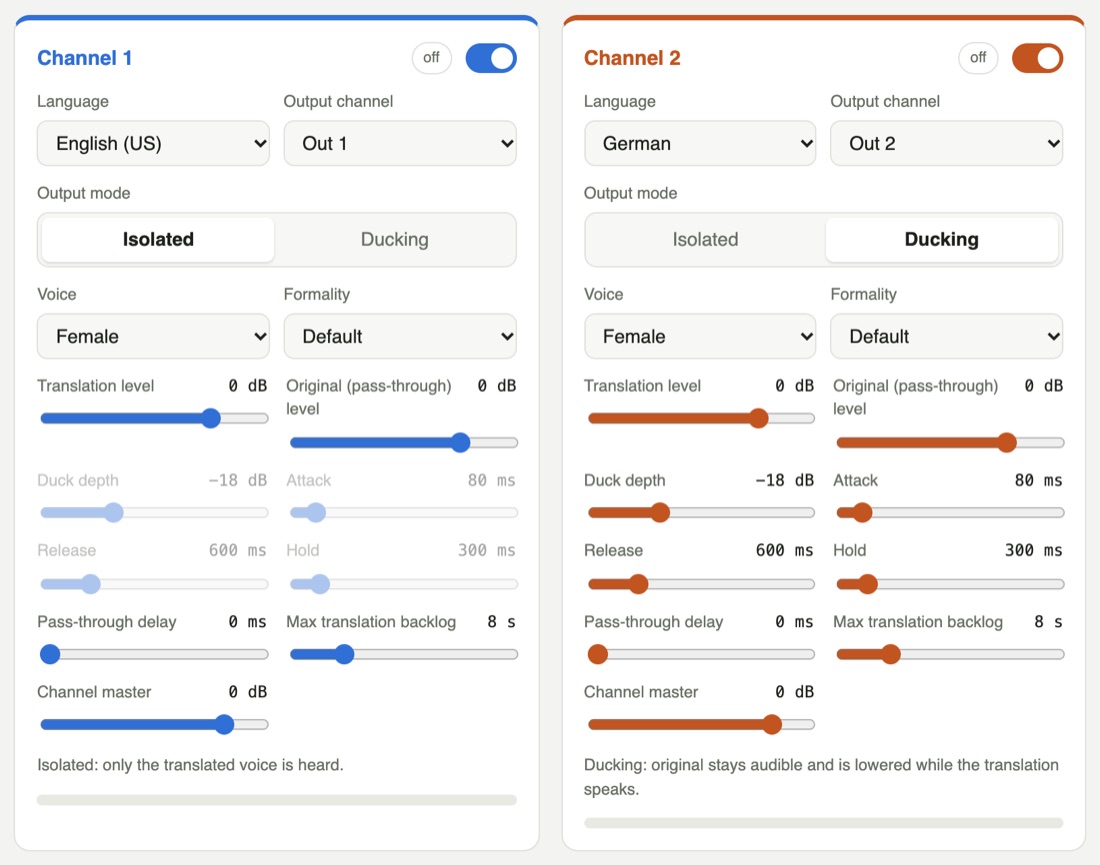
Isolé ou en ducking, par canal
Isolé n’envoie que la voix traduite, comme un flux d’interprète. Le ducking garde l’original en dessous et l’abaisse pendant que la traduction parle, comme un voice‑over à la télévision.
Un timing qui survit à une fenêtre réduite
L’enveloppe de ducking suit l’horloge audio, pas un minuteur d’interface. Elle reste précise quand la fenêtre est en arrière‑plan, ce qui est le cas habituel sur une machine de production.
Un vrai routage
Chaque langue peut aller vers n’importe quelle sortie physique de l’interface : directement dans une console, un encodeur de stream ou un système d’interprétation.
Réglable par canal
- Langue et voix
- Canal de sortie
- Isolé ou ducking
- Profondeur, attaque, maintien, relâchement
- Niveaux de la traduction et de l’original
- Retard de l’original
- Retard de traduction maximal
- Master du canal
Autonome
Parce qu’une machine de production n’est pas une machine de développement
Tourne sur votre Mac
Une seule app pour Intel et Apple Silicon, macOS 13.5 ou plus récent. Elle embarque son propre environnement d’exécution. Une version Windows est en développement.
La clé reste sur la machine
La clé API est saisie une fois et stockée localement, lisible uniquement par ce compte utilisateur.
Local uniquement
L’app n’accepte que les connexions de l’ordinateur lui‑même et refuse les requêtes d’autres sites web.
Nécessite un navigateur Chromium
Chrome, Edge ou Brave doit être installé : ils savent envoyer l’audio vers un canal de sortie choisi.
Au‑delà de la régie
Speech Connect pour votre public
Speech Connect atteint aussi directement le public : reconnaissance vocale et traduction en plusieurs langues à la fois, transmises aux auditeurs avec des outils qui les impliquent.
Reconnaissance en temps réel
La reconnaissance vocale transforme la voix en texte pendant qu’on parle.
Plusieurs langues
Traduire un discours en plusieurs langues en même temps, avec des voix naturelles.
Streaming en direct
Diffuser les traductions en direct à votre public, lors d’événements et de présentations.
Streaming audio
Transmettre l’audio traduit directement à vos auditeurs.
Sous‑titres en direct
Sous‑titres multilingues pour événements live, webinaires et vidéos.
Chat interactif
Le public discute et donne son avis, par‑delà les barrières de la langue.
Votes en direct
Sondages et votes multilingues pour les Q&R, enquêtes et présentations interactives.
Jeux interactifs
Jeux de mots et quiz multilingues qui gardent le public engagé.
Limites honnêtes
Ce qu’il ne sait pas (encore) faire
Connaissez les compromis avant de passer à l’antenne.
Il suit l’orateur avec quelques secondes de retard
La traduction se fait phrase par phrase. C’est adapté à un canal de langue en livestream ou à un town hall interne, mais cela ne remplace pas des interprètes simultanés dans les situations à fort enjeu.
Chaque langue a un coût
Chaque canal traduit est une session temps réel distincte, facturée comme telle : quatre langues consomment quatre fois plus de minutes.
La détection a besoin des premiers mots
Jusque‑là, l’app ne connaît pas la langue de l’orateur. Un court retard sur l’original couvre ce moment, une langue d’entrée fixe l’évite.
Il faut un navigateur Chromium
Chrome, Edge ou Brave, car ils savent router l’audio vers un canal de sortie choisi.
FAQ
Questions fréquentes
Que fait exactement Speech Connect ?
Il prend un orateur sur une entrée de votre interface audio, traduit sa parole en temps réel et la reparle dans jusqu’à quatre langues. Chaque langue sort sur son propre canal et peut aller directement dans une console, un encodeur de stream ou un système d’interprétation.
À qui s’adresse‑t‑il ?
À tous ceux qui gèrent le son pour un public multilingue : assemblées générales, conférences et événements live, livestreams, town halls internes et réunions hybrides. Le but est simple : que personne dans le public ne reste de côté.
Combien de langues en même temps ?
Jusqu’à quatre canaux de sortie, chacun dans sa langue, depuis une seule entrée. Les canaux 1 et 2 sont actifs par défaut ; les canaux 3 et 4 démarrent désactivés pour que rien ne tourne ni ne coûte par erreur. En option, Speech Connect gère jusqu’à 16 langues de traduction.
Remplace‑t‑il les interprètes simultanés ?
Non. La traduction suit l’orateur avec quelques secondes de retard, phrase par phrase. Pour les négociations et autres situations à fort enjeu, faites appel à des interprètes. Il convient là où un canal de langue propre et automatique suffit, par exemple en livestream, lors d’une assemblée générale ou d’un événement interne.
Quel est le retard de la traduction ?
En général quelques secondes, car la traduction se fait phrase par phrase. Une limite par canal, le retard de traduction maximal, abandonne la parole en attente si un canal prend trop de retard, pour qu’il rattrape au lieu de dériver.
À quoi ressemble la voix traduite ?
Chaque canal parle avec une voix féminine, masculine ou proche de celle de l’orateur. Vous choisissez par canal.
Le public entend‑il encore l’orateur original ?
Oui, si vous le souhaitez. En mode ducking, l’original reste en dessous et baisse pendant que la traduction parle, comme un voice‑over à la télévision. En mode isolé, seule la traduction est audible, comme un flux d’interprète. Vous choisissez par canal.
Et si l’orateur parle déjà la langue d’un canal ?
Ce canal reçoit alors la voix originale, pas une relecture par une machine. Avec une langue d’entrée fixe, ce canal n’ouvre même pas de session de traduction.
Et si l’orateur change de langue ?
Avec la détection automatique, la langue est reconnue au fil de la parole. Le canal dans la langue parlée reçoit la voix originale. La détection a besoin des premiers mots ; un retard sur l’original couvre ce moment, ou vous fixez la langue d’entrée.
Quelles langues sont prises en charge ?
Les langues de sortie sont celles que l’API de traduction en temps réel propose en synthèse vocale. Indiquez vos langues dans le formulaire, nous les confirmerons avant la démo.
Est‑ce compatible avec ma console, mon encodeur ou mon système d’interprétation ?
Chaque langue peut aller vers n’importe quelle sortie physique de votre interface audio. À partir de là, c’est un flux audio ordinaire pour votre console, votre encodeur de stream ou votre système d’interprétation.
Quels paramètres sont réglables par canal ?
Langue, voix, canal de sortie, isolé ou ducking, profondeur, attaque, maintien et relâchement, niveaux de la traduction et de l’original, retard de l’original, retard de traduction maximal et master du canal.
Puis‑je contrôler ce qui est dit ?
Oui. Une transcription en direct affiche l’original et chaque canal en continu.
Fonctionne‑t‑il quand la fenêtre est en arrière‑plan ?
Oui. Le ducking suit l’horloge audio et non un minuteur d’interface ; il reste précis même si la fenêtre est réduite ou masquée.
De quoi ai‑je besoin ?
Un Mac sous macOS 13.5 ou plus récent (Intel ou Apple Silicon), Chrome, Edge ou Brave installé, une interface audio, une connexion internet et un abonnement Speech Connect. L’app embarque son propre environnement d’exécution, rien d’autre à installer.
Fonctionne‑t‑il sous Windows ?
Une version Windows est en développement. Aujourd’hui, Speech Connect pour la régie tourne sur Mac ; dites‑nous dans le formulaire si vous attendez Windows.
Puis‑je utiliser des entrées au‑delà de 1 et 2 ?
Certaines interfaces multicanal n’exposent au navigateur que leurs deux premières entrées. Routez l’orateur vers l’entrée 1 ou 2 dans le mixeur de l’interface, ou utilisez un périphérique agrégé macOS.
Où vont mon audio et ma clé API ?
L’audio est envoyé à l’API de traduction en temps réel pour la transcription, la traduction et la synthèse vocale. La clé API est stockée localement sur le Mac, lisible uniquement par votre compte utilisateur, et l’app n’accepte que les connexions de l’ordinateur lui‑même.
Est‑il conforme au RGPD ?
Oui. Speech Connect est développé en Autriche, dans l’Union européenne, et est conforme au RGPD. L’app stocke sa clé localement et n’accepte que les connexions de l’ordinateur lui‑même ; ce site ne dépose aucun cookie et n’utilise aucun suivi.
Comment l’utilisation est‑elle facturée ?
Speech Connect est un service par abonnement (SaaS). Chaque canal traduit est une session temps réel distincte, facturée comme telle : quatre langues consomment quatre fois plus de minutes. Un canal dont la langue correspond à une langue d’entrée fixe n’ouvre aucune session.
Combien ça coûte ?
Speech Connect est proposé par abonnement. Le prix dépend de votre configuration et du nombre de langues. Choisissez « Contacter les ventes » dans le formulaire et nous vous enverrons une offre.
Le public peut‑il suivre de son côté ?
La plateforme Speech Connect pour le public ajoute le streaming audio vers les auditeurs, des sous‑titres en direct, le chat, les votes et des jeux. Demandez‑nous dans le formulaire.
Contact
Découvrez‑le avec vos langues
Réservez une démo ou interrogez les ventes sur votre événement. Parlez‑nous de votre configuration, nous vous répondrons par e‑mail.
Pas de newsletter, pas de suivi. Vos données servent uniquement à vous répondre.
Merci, votre demande est en route.
Nous répondons par e‑mail, généralement sous deux jours ouvrés.